
Non ho mai capito la recente e diffusa passione per i sondaggi elettorali dopo anni di continue figuracce. Poi mi sono detto: magari ora sono più precisi e vengono presentati in maniera più corretta!
E invece no.
Prendo come esempio questo articolo di la Repubblica dove viene riportato e commentato questo sondaggio di SWG, commissionato da La7:
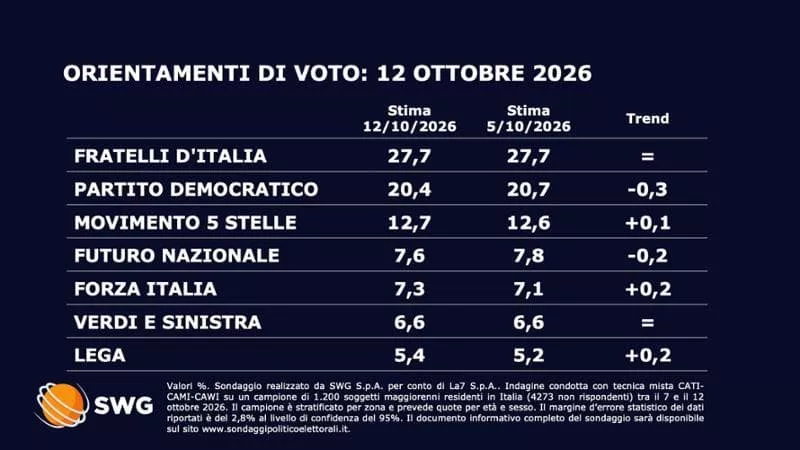
Sotto, in piccolo, si legge che il campione è di 1.200 persone, più altre 4.273 che non hanno voluto rispondere. Inoltre c’è scritto che “il margine d’errore statistico dei dati riportati è del 2,8%”.
Ma cosa vuol dire? Il calo del Partito Democratico dello 0,3%, o di Futuro Nazionale dello 0,2%, così come l’aumento dello 0,1% del Movimento 5 Stelle sono tendenze reali oppure normali oscillazioni statistiche del campione?
La risposta è che, con questi dati, non possiamo saperlo.
Per fare un esempio, il 27,7% attribuito a Fratelli d’Italia corrisponde, applicando quel margine dichiarato, a un intervallo compreso tra il 24,9% e il 30,5%. Due estremi che disegnano scenari abbastanza diversi.
Non solo. Quando si fa la differenza fra due stime, ognuna con il 2,8% di margine d’errore, l’errore sulla loro differenza è ancora maggiore, e saliamo a quasi il 4%.
Ma anche il margine dichiarato non è ben spiegato, perché assume quel valore solo quando una stima si avvicina al 50%.
Per esempio, la variazione per il PD si colloca in questa posizione rispetto al suo intervallo di incertezza:
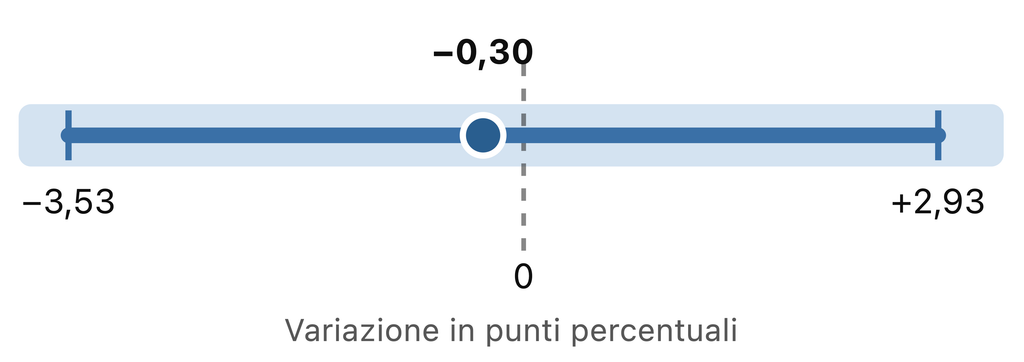
È ben chiaro, quindi, che oscillazioni di uno, due o tre decimi di punto non dimostrano affatto che un partito abbia guadagnato o perso consensi. Il PD potrebbe in realtà aver guadagnato il 2% o perso il 3% questa settimana, ma questo sondaggio non avrebbe comunque potuto accorgersene.
Poi c’è un altro grave problema: le 4.273 persone che non hanno risposto. Non sappiamo perché non abbiano voluto rispondere e se abbiano orientamenti politici diversi da quelli di chi ha partecipato. Si può facilmente immaginare che, in questo caso, il campione possa risultare molto distorto. E questo tipo di errore non è necessariamente compreso nel margine statistico dichiarato, che potrebbe aumentare ancora di più.
Quando i risultati vengono presentati con una precisione al decimo di punto percentuale, accompagnati da segni più e meno che suggeriscono movimenti dell’elettorato, come se fossimo davanti a misurazioni precise, ci troviamo davanti ad un grosso problema di metodo e di comunicazione.
Per la foga di trasformare ogni oscillazione decimale in una notizia, si arriva a ingigantire il valore statistico di un sondaggio che invece ne ha molto poco.
E si influenzano le persone presentando una realtà che potrebbe non esistere.
Formule
La formula utilizzata per calcolare il margine d’errore di una stima è quella dell’intervallo di confidenza per una proporzione, basata sull’approssimazione normale della distribuzione binomiale:
Nel calcolo della differenza fra due stime indipendenti si utilizza invece la formula del margine d’errore della differenza tra due proporzioni:
Per un livello di confidenza del 95% si utilizza z=1,96, perché nella distribuzione normale standardizzata il 95% della probabilità si trova nell’intervallo compreso tra −1,96 e +1,96 deviazioni standard dalla media. La lettera p è la proporzione stimata e n è la dimensione del campione. La seconda formula presuppone che i due campioni siano indipendenti.
Per approfondimenti: Pennsylvania State University, Lesson 8 e 9.
Lascia un commento